
当AI在近期的网络安全事件中频繁扮演关键角色,AI成了一柄双刃剑就愈发得到大众的认同。AI不仅能帮你做PPT、写文案、画图、输出代码,也能威胁到你的安全。就在近日,央视网报道了一起杭州市中级人民法院公布的案例,其中显示AI生成视频已经能逃过人脸识别系统。
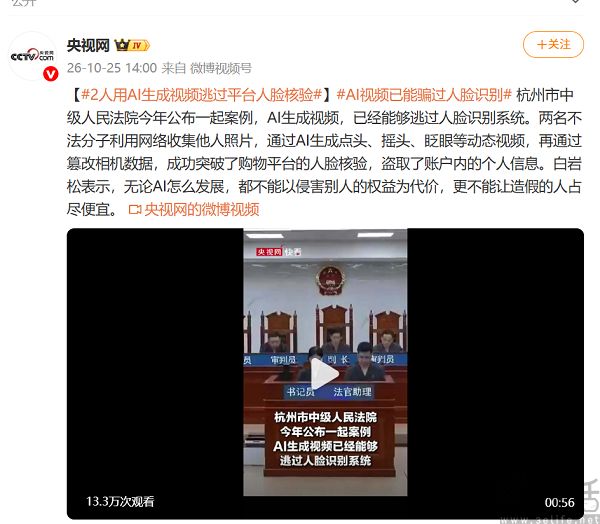
据悉,不法分子利用网络收集他人照片,通过AI生成点头、摇头、眨眼等动态视频,再通过篡改相机数据,成功突破购物平台的人脸核验,盗取了账户内的个人信息。这个案例就表明,AI视频技术的滥用,已经开始破坏以往的信任秩序。
点头、摇头、眨眼,是我们在向App证明“我是我”时,需要对着手机的前置摄像头进行的操作。在2015年前后,深度学习技术让人脸识别准确率大幅提升,算法的准确率开始超过人眼的水平,为大规模商用扫清了技术障碍。时至今日,人脸识别已经成为大量互联网产品确认用户身份的主要途径。
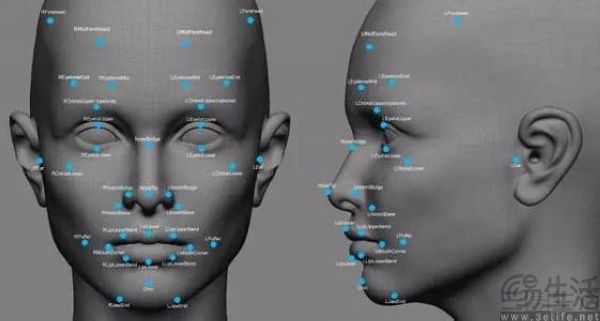
不仅支付宝等金融类App,京东、淘宝等电商平台,乃至抖音、微信都在大规模使用人脸识别。需要注意的是,此次被AI攻破的人脸识别并非是iPhone使用的Face ID等3D结构光人脸识别,而是2D人脸识别。相较3D结构光技术是通过投射的潜望结构光线扫描采集人脸信息,通过“点”对“面”的特殊算法构成三维图像,所看到的是立体的人脸,2D人脸识别看到的则是平面。
我们在手机上实现从面部识别到解锁的过程中,至少包括了人脸检测、特征提取,以及人脸识别这些步骤。其中,人脸检测顾名思义,就是让系统从全景画面里,精准地抠出用户的脸部区域进行验证;特征提取则是通过计算机视觉提取人脸的两眼间距、鼻宽、脸型轮廓、皮肤纹理、皱纹走向等信息;人脸识别是将待识别的人脸与数据库中的相关数据进行比对,用算法来衡量人脸之间的相似度。
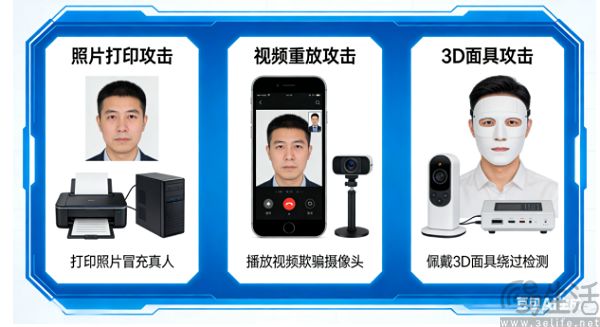
但2D人脸识别有个致命的短板,那就是它只认脸、不认人。照片、视频、甚至硅胶面具都可能会骗过它,为此开发者引入了“活体检测”,点头、摇头、眨眼这些动作,其实是开发者试图证明镜头前的“脸”是真人的面孔。到了2017年,一项名为deepfake(深度伪造)的技术在Reddit上出现,利用生成式对抗网络(GAN)和深度学习算法实现了十分逼真可信的换脸视频。
为了对抗深度伪造,开发者利用光线来分辨视频和真人。由于真实的人脸是立体的,光线照射后,不同部位(比如鼻子、脸颊、眼睛)的反射强度和角度都不一样,并且真实的皮肤含水,也会吸收部分光线。而照片、面具则是平面的,反射的光线模式单一,人脸识别算法通过对比光反射的细微差别,就能轻松识破伪造。
传统的深度伪造内容无法还原光线照射在人脸的真实反馈,但AI视频模型就可以做到。早在2024年OpenAI发布Sora时,就号称其是“世界模拟器”,AI能够理解、预测和推理现实世界的运作方式,其中就包括物理规律、因果关系和物体运动。
时至今日,世界模型已经不是什么新鲜事物,最先进的AI已经能够理解“水为何会往低处流”“球撞到墙上为什么会弹回来”。Seedance、可灵等SOTA级别的AI视频模型已经能够做到以假乱真,有AI视频创作者就感叹,“当年威尔·史密斯吃面的AI视频不也是个笑话吗,现在呢?”
此前在2023年,威尔·史密斯吃意大利面的AI视频曾被网友嘲讽“像没牙老太太嚼空气”,出现叉子穿脸、面条像蛇一样扭动、咀嚼动作像木偶等穿帮镜头,整体像恐怖片又像鬼畜素材。如今,“电影质感”已然成为抖音、快手上精品AI内容的标配。
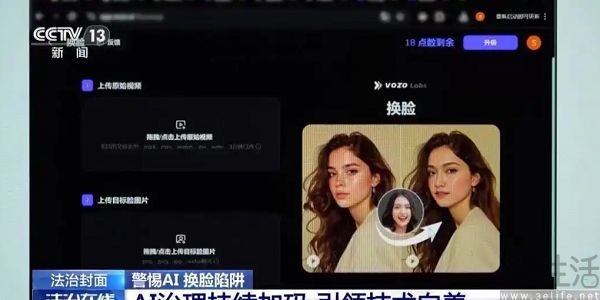
换而言之,现在的顶级AI视频模型能够理解不同光线照在人脸上应该呈现何种状态。所以只要黑客肯花功夫,通过收集用户公开发布的照片,再喂给AI,最终输出一段惟妙惟肖的视频,从而骗过非3D结构光的人脸识别,在理论上就具备可行性。
AI模型解析图片内容,识别主体、背景、光影等元素,再基于提示词指令,生成连续动态帧,并拼接成流畅视频,这一套操作已经是AI视频模型的基础用法。作为关键帧的图片越多、越详细,AI生成的视频就越可控、越连贯、越逼真。
从某种意义上来说,此次央视网报道的“AI视频已能骗过人脸识别”,其实是一次新技术搭配社会工程学的结果。反过来,如果你基本不在公开网络发布个人的日常生活照,黑客想要制作AI视频也是巧妇难为无米之炊。
然而经过QQ、Facebook、Instagram、微信等各类社交软件二十余年的浸润,以及“自拍文化”的洗礼,几乎不在网络上发照片的人可以说是少之又少。因此AI视频模型伪装真人不是少数人需要面对的威胁,而是全社会要共同面对的挑战。
几乎可以预见的是,随着AI视频模型的能力逐步迭代,并逐步向世界模型靠拢,它理解世界运行规律的能力持续进化,会被AI欺骗的互联网平台将越来越多。